Quivr là một dự án mã nguồn mở tập trung vào RAG, viết bằng Python, với mục tiêu giúp đội ngũ phát triển đưa Generative AI vào ứng dụng mà không phải tự xây toàn bộ lớp truy xuất dữ liệu từ đầu. README chính thức định vị Quivr là một RAG có định hướng, để đội ngũ tập trung vào sản phẩm thay vì tự xây lớp RAG.
Với truy vấn “Quivr tích hợp AI vào ứng dụng”, điểm đáng chú ý không nằm ở việc Quivr thay thế hoàn toàn một nền tảng AI, mà ở vai trò lớp kết nối giữa dữ liệu của ứng dụng và mô hình ngôn ngữ. Quivr có thể tiếp nhận các tệp như PDF, TXT, Markdown, thực hiện truy xuất và đưa phần thông tin phù hợp vào quá trình tạo câu trả lời. README cũng cho biết dự án hỗ trợ nhiều LLM và cho phép tùy biến RAG.
Dữ liệu được cung cấp cho bài viết cho thấy repository The-Vibe-Company/quivr có 39.471 sao và sử dụng Python. Đây là số liệu tại thời điểm thu thập dữ liệu cho bài viết. Khi đối chiếu với README hiện hành của dự án QuivrHQ/quivr, định hướng cốt lõi vẫn là RAG để tích hợp GenAI vào ứng dụng.
Quivr là gì?
Quivr có thể hiểu đơn giản là một lớp RAG dành cho các ứng dụng muốn khai thác dữ liệu riêng bằng AI. Thay vì chỉ gửi câu hỏi trực tiếp tới một mô hình ngôn ngữ, hệ thống có thể tìm những đoạn dữ liệu liên quan trước, sau đó đưa chúng vào ngữ cảnh để mô hình tạo câu trả lời.
README của dự án nêu khả năng làm việc với nhiều LLM và nhiều loại tệp. Quivr cũng cho phép tùy chỉnh RAG, bổ sung tìm kiếm internet hoặc công cụ tùy theo nhu cầu của ứng dụng. Đây là điểm quan trọng với doanh nghiệp: dữ liệu dùng để trả lời không nhất thiết phải nằm trong chính mô hình AI.
Ở mức triển khai, README yêu cầu Python 3.10 hoặc mới hơn. Ví dụ Getting Started sử dụng gói quivr-core, sau đó tạo một đối tượng Brain từ tệp dữ liệu và gửi câu hỏi cho Brain.
README cũng minh họa một cấu hình workflow gồm các bước lọc lịch sử hội thoại, viết lại câu hỏi, truy xuất và tạo câu trả lời. Điều này cho thấy Quivr không chỉ là một hàm gọi LLM đơn lẻ mà có thể được cấu hình thành một quy trình RAG.
Cách Quivr tích hợp AI vào ứng dụng
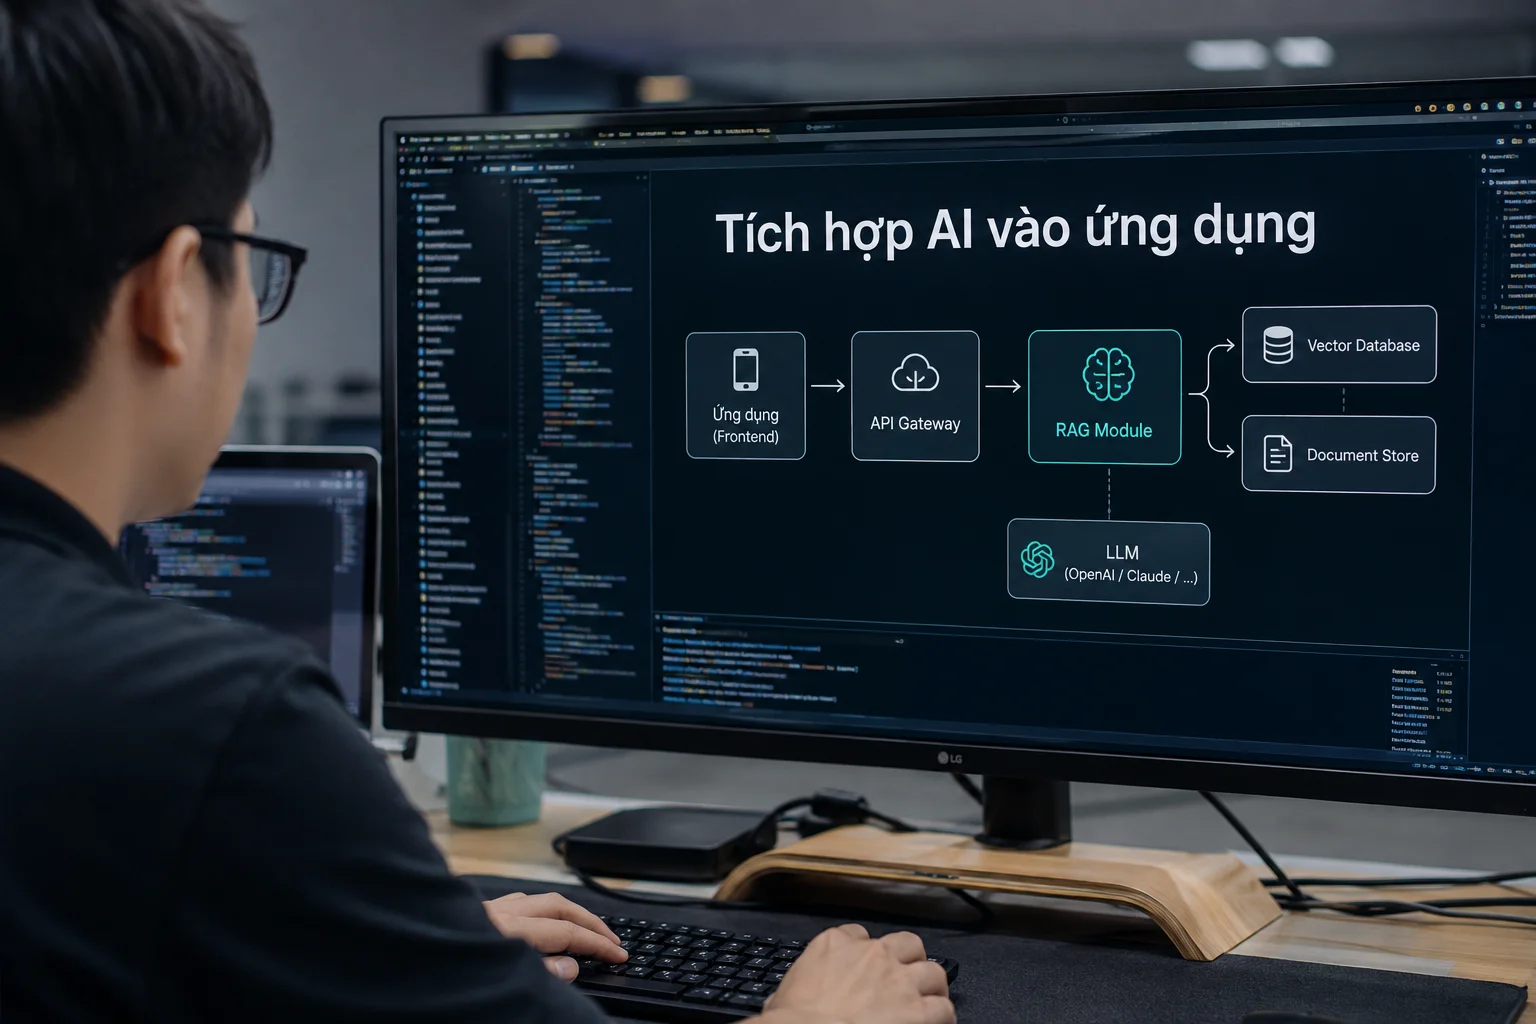
Luồng cơ bản có thể hình dung theo ba phần: dữ liệu đầu vào, lớp truy xuất và mô hình tạo sinh. Ứng dụng cung cấp tài liệu hoặc nguồn dữ liệu cho Quivr. Quivr xử lý và tìm thông tin phù hợp với câu hỏi. Sau đó, phần ngữ cảnh được sử dụng để tạo câu trả lời thông qua LLM đã cấu hình.
Bạn đưa tài liệu và câu hỏi vào → Quivr tìm dữ liệu liên quan và tạo ngữ cảnh → mô hình AI trả về câu trả lời dựa trên dữ liệu đó.
Ví dụ trong README, Quivr có thể tạo một Brain từ tệp TXT rồi gọi phương thức ask để đặt câu hỏi. Với ứng dụng doanh nghiệp, mô hình này có thể được mở rộng thành kho tài liệu nội bộ, trợ lý cho nhân viên hoặc một tính năng hỏi đáp nằm ngay trong phần mềm hiện có.
README đưa ra cách cài đặt quivr-core bằng pip và ví dụ tạo một RAG với đoạn mã ngắn. Vì vậy, về mặt kỹ thuật, Quivr hướng tới việc giảm lượng thành phần RAG mà đội phát triển phải tự xây.
Tuy nhiên, “dễ tích hợp” không đồng nghĩa với “không cần kỹ thuật”. Đội ngũ triển khai vẫn phải chuẩn bị môi trường Python, API key hoặc mô hình cục bộ, dữ liệu đầu vào, cấu hình workflow và cách ứng dụng gọi Quivr. Khi đưa vào môi trường doanh nghiệp, còn phải tính đến phân quyền, dữ liệu nhạy cảm, giám sát và khả năng vận hành.
Hướng dẫn triển khai Quivr từng bước
Bước 1: Xác định bài toán. Trước tiên, cần xác định ứng dụng sẽ dùng AI để làm gì, chẳng hạn hỏi đáp tài liệu nội bộ, tra cứu tài liệu kỹ thuật hoặc hỗ trợ nhân viên tìm kiếm thông tin.
Bước 2: Chuẩn bị môi trường. README của Quivr yêu cầu Python 3.10 hoặc mới hơn. Đội phát triển cần chuẩn bị môi trường Python và cài gói quivr-core theo hướng dẫn của dự án.
Bước 3: Chuẩn bị dữ liệu. Chọn các tài liệu mà ứng dụng được phép sử dụng, chẳng hạn PDF, TXT hoặc Markdown. Cần kiểm tra chất lượng, tính cập nhật và quyền truy cập trước khi đưa dữ liệu vào RAG.
Bước 4: Chọn mô hình AI. Có thể cấu hình nhà cung cấp LLM phù hợp với yêu cầu của ứng dụng. README đề cập OpenAI, Anthropic và Mistral, đồng thời hỗ trợ mô hình cục bộ thông qua Ollama.
Bước 5: Tạo RAG và nạp dữ liệu. Theo ví dụ Getting Started, có thể tạo một Brain từ tệp dữ liệu. Đây là lớp để ứng dụng tổ chức dữ liệu và thực hiện quá trình truy xuất trước khi tạo câu trả lời.
Bước 6: Kết nối chức năng hỏi đáp. Ứng dụng gửi câu hỏi tới Brain thông qua phương thức phù hợp, nhận kết quả rồi hiển thị trong giao diện. Ở bước này có thể xây thêm giao diện chat, tìm kiếm hoặc trợ lý AI tùy nghiệp vụ.
Bước 7: Kiểm thử trước khi mở rộng. Nên kiểm tra độ chính xác của truy xuất, chất lượng câu trả lời, thời gian phản hồi, chi phí mô hình và khả năng xử lý các câu hỏi không có dữ liệu phù hợp.
Bước 8: Hoàn thiện bảo mật và vận hành. Khi triển khai thực tế, cần thiết lập quyền truy cập dữ liệu, kiểm soát API key, theo dõi lỗi và xác định dữ liệu nào được phép gửi tới dịch vụ AI bên ngoài.
Làm được gì
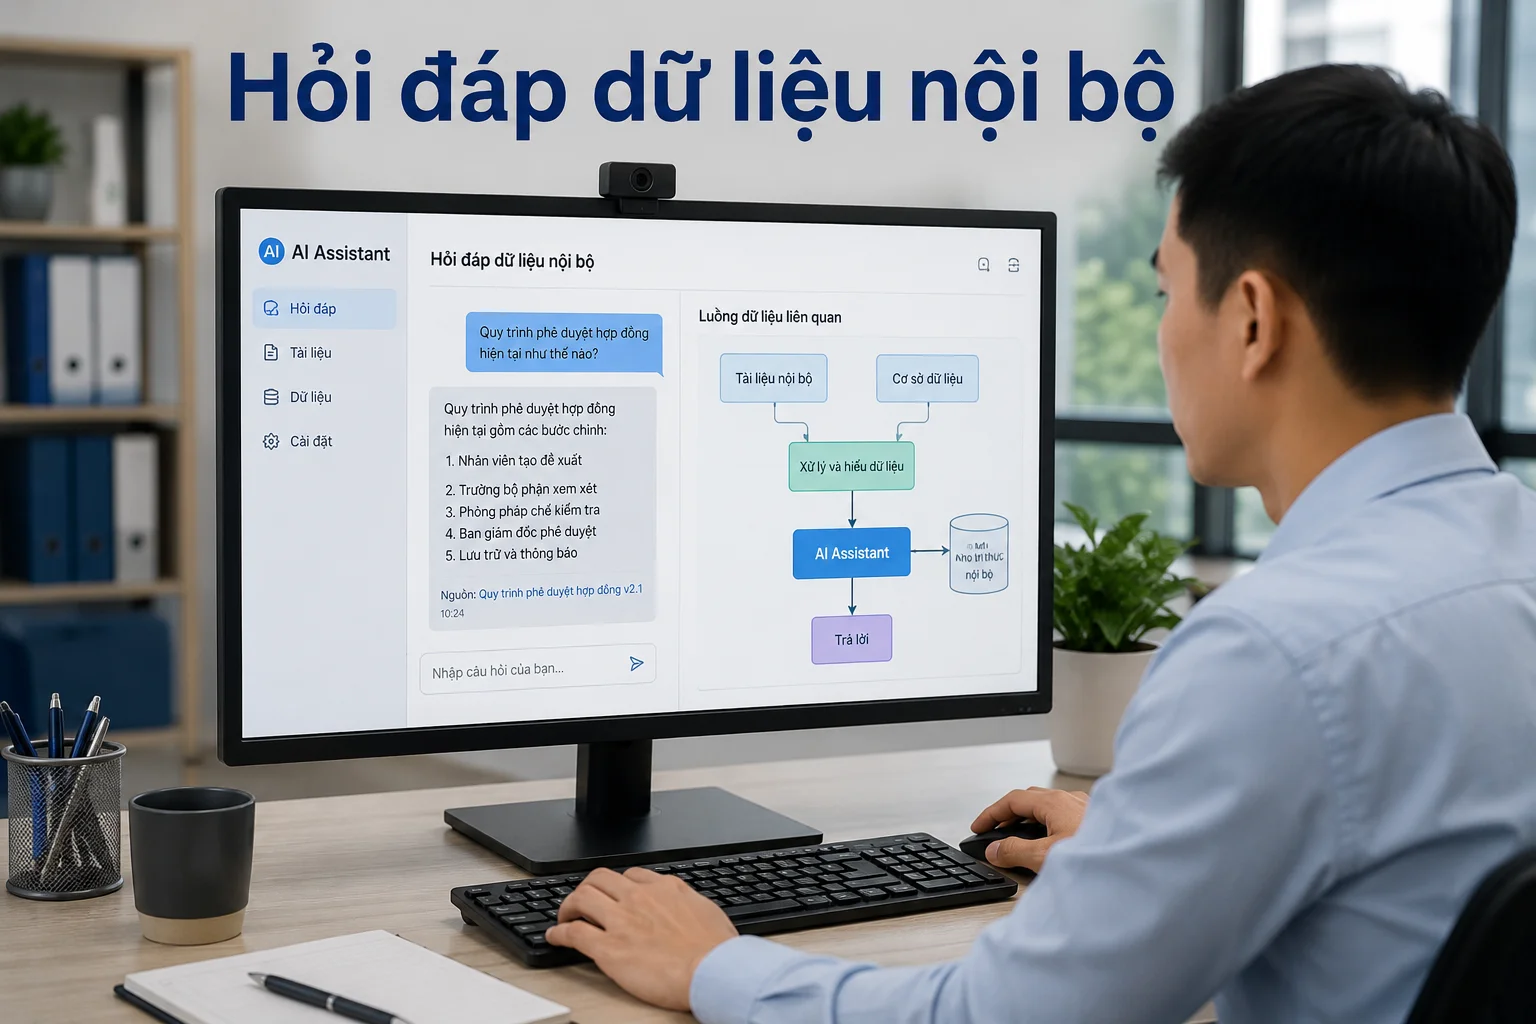
Tình huống 1: tra cứu tài liệu sản phẩm và chính sách. Bộ tài liệu được phép sử dụng có thể được đưa vào hệ thống RAG và tích hợp ô hỏi đáp vào phần mềm nội bộ. Người dùng đặt câu hỏi, Quivr truy xuất nội dung liên quan rồi đưa ngữ cảnh cho LLM tạo câu trả lời.
Tình huống 2: hỗ trợ tra cứu tài liệu kỹ thuật. Các hướng dẫn, tài liệu kỹ thuật hoặc Markdown có thể được đưa vào hệ thống. Một giao diện trợ lý nằm trong ứng dụng nội bộ có thể tiếp nhận câu hỏi và truy xuất nội dung liên quan thay vì yêu cầu người dùng tìm thủ công qua nhiều tệp.
Tình huống 3: bổ sung tính năng AI cho ứng dụng SaaS. Quivr có thể đảm nhiệm phần truy xuất dữ liệu, trong khi đội sản phẩm tập trung vào giao diện, nghiệp vụ và trải nghiệm người dùng. Đây là trường hợp sát với định hướng của repository: xử lý phần RAG để đội ngũ tập trung vào sản phẩm.
Ghép với công cụ khác
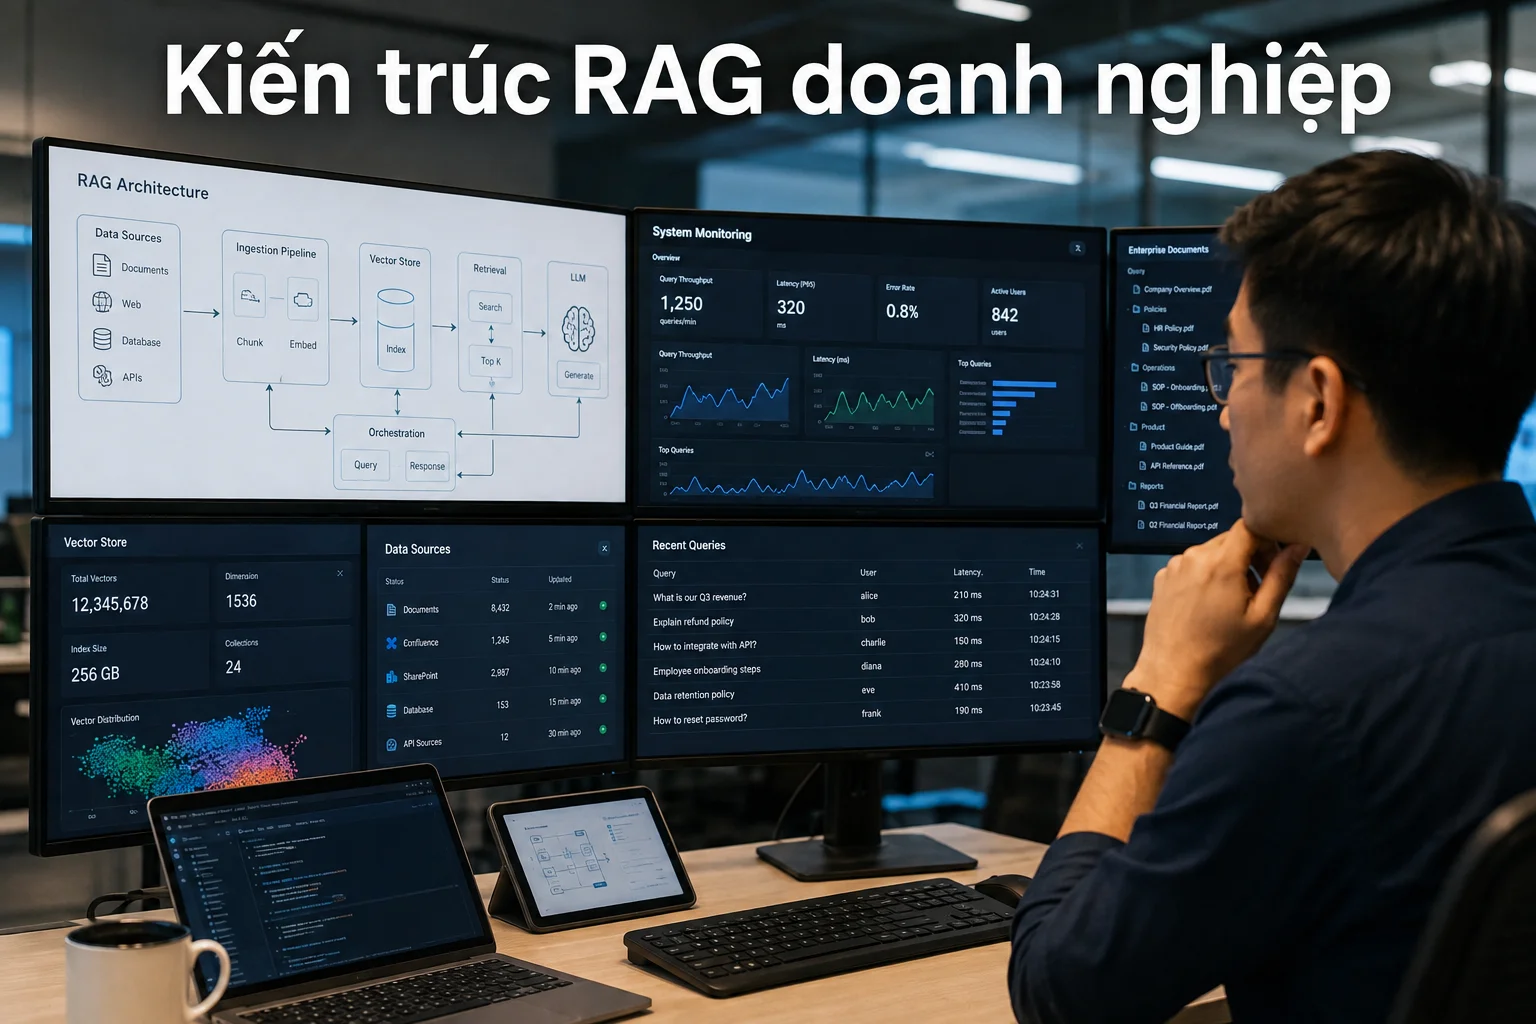
Quivr có thể nằm giữa dữ liệu doanh nghiệp và lớp AI, sau đó kết hợp với các thành phần khác tùy kiến trúc. Cần phân biệt giữa tích hợp được dự án xác nhận và kịch bản do đội phát triển tự thiết kế.
README của Quivr đề cập tích hợp với Megaparse, phù hợp cho bài toán cần xử lý và ingest tài liệu trước khi đưa dữ liệu vào RAG.
Ở tầng trợ lý hoặc agent, các dự án như AstrBot hoặc Hermes Agent có thể được đặt cùng một kiến trúc do đội phát triển thiết kế. Chẳng hạn, agent tiếp nhận câu hỏi, chuyển yêu cầu cần tra cứu tài liệu sang Quivr, rồi nhận kết quả truy xuất để tiếp tục xử lý. Đây là kịch bản kiến trúc, không nên hiểu là integration chính thức nếu tài liệu dự án không xác nhận.
So với các dự án AI liên quan
Bảng dưới đây chuẩn hóa số sao, ngôn ngữ, giấy phép và mốc cập nhật theo đúng dữ liệu được cung cấp. Các dự án không nhất thiết cùng chức năng với Quivr; phần “vai trò chính” giúp làm rõ đối tượng so sánh.
| tên | sao | ngôn ngữ | giấy phép | cập nhật | vai trò chính | so với Quivr |
|---|---|---|---|---|---|---|
| Quivr | 39471 | Python | Không có dữ liệu trong khối nguồn | Không có dữ liệu trong khối nguồn | RAG cho ứng dụng GenAI | Tập trung vào truy xuất dữ liệu, tích hợp LLM và tùy biến workflow. |
| AstrBot | 39698 | Python | GNU Affero General Public License v3.0 | 2026-08-27T11:04:57Z | AI Agent Assistant và framework tích hợp | Thiên về agent, trợ lý và tích hợp nhiều nền tảng; Quivr thiên về lớp RAG và truy xuất dữ liệu. |
| f/prompts.chat | 167859 | HTML | Other | 2026-08-24T03:24:40Z | Bộ sưu tập và khám phá prompt | Tập trung vào prompt; Quivr tập trung vào dữ liệu riêng, truy xuất và tạo câu trả lời. |
| NousResearch/hermes-agent | 232520 | Python | MIT License | 2026-08-18T22:58:05Z | AI Agent | Tập trung vào agent; Quivr tập trung vào RAG và lớp dữ liệu phục vụ ứng dụng AI. |
Nhận định của Việt Tiến IT
Qua cách tổ chức README và ví dụ triển khai, chúng tôi đánh giá Quivr đáng thử khi doanh nghiệp đã có một ứng dụng cụ thể và muốn bổ sung khả năng hỏi đáp trên dữ liệu riêng. Đánh giá này dựa trên các tiêu chí gồm khả năng tích hợp Python, chức năng RAG, mức độ tùy biến workflow và khả năng kết nối dữ liệu riêng.
Quivr phù hợp hơn với bài toán đã xác định rõ dữ liệu cần tra cứu, nhóm người dùng và nghiệp vụ cần hỗ trợ. Đội phát triển có thể bắt đầu từ một Brain nhỏ, thử dữ liệu thật ở phạm vi kiểm soát rồi đánh giá chất lượng truy xuất, câu trả lời và khả năng tích hợp trước khi mở rộng workflow.
Ngược lại, Quivr không tự giải quyết chất lượng dữ liệu hoặc yêu cầu quản trị của ứng dụng. Doanh nghiệp cần xác định dữ liệu nào được phép đưa vào, ai được truy cập và câu trả lời được sử dụng vào nghiệp vụ nào. Tài liệu sai, cũ hoặc phân quyền không rõ vẫn có thể dẫn tới kết quả không phù hợp.
Về vận hành, các tiêu chí cần kiểm tra gồm lựa chọn LLM, chất lượng ingest, chiến lược truy xuất, cấu hình reranker, độ dài ngữ cảnh, quyền truy cập dữ liệu và chi phí. README của Quivr cho phép cấu hình các thành phần như LLM, reranker và số lượng chunk, vì vậy đội kỹ thuật nên kiểm thử theo dữ liệu và yêu cầu thực tế thay vì mặc định sử dụng cấu hình mẫu.
Về bảo mật, doanh nghiệp nên xác định ngay từ đầu dữ liệu nào được lưu, dữ liệu nào được gửi tới dịch vụ AI bên ngoài và dữ liệu nào cần xử lý bằng mô hình cục bộ. README cho biết Quivr hỗ trợ API của Anthropic, OpenAI, Mistral và mô hình cục bộ thông qua Ollama; lựa chọn phù hợp phụ thuộc vào yêu cầu bảo mật, chất lượng và hạ tầng của từng hệ thống.
Với các dự án cần xây dựng tính năng AI gắn chặt vào phần mềm hiện có, Việt Tiến IT đánh giá Quivr phù hợp để đưa vào vòng thử nghiệm kỹ thuật khi các tiêu chí về Python, RAG, dữ liệu riêng, tùy biến workflow và yêu cầu vận hành đã được xác định. Cách tiếp cận phù hợp là triển khai một bài toán nhỏ, đo chất lượng truy xuất và câu trả lời, kiểm tra quyền dữ liệu rồi mới quyết định mở rộng. Nếu doanh nghiệp cần hỗ trợ từ khâu phát triển phần mềm theo yêu cầu đến AI & Automation và hướng dẫn, triển khai AI trợ lý cho công việc, đây cũng là hướng có thể kết hợp trong một dự án tổng thể.
Nguồn tham khảo ngoài: GitHub, repository QuivrHQ/quivr và tài liệu README của gói quivr-core. Các thông tin kỹ thuật về cách cài đặt, Python 3.10+, Brain, workflow RAG, LLM và Megaparse được đối chiếu từ tài liệu chính thức của dự án.
Câu hỏi thường gặp
Quivr có phù hợp để thêm tính năng hỏi đáp tài liệu vào phần mềm không?
Có. Quivr có thể đảm nhiệm lớp RAG để ứng dụng truy xuất dữ liệu liên quan rồi đưa ngữ cảnh cho mô hình ngôn ngữ tạo câu trả lời.
Khi triển khai Quivr, doanh nghiệp cần chuẩn bị những gì?
Cần xác định bài toán, chuẩn bị môi trường Python, dữ liệu được phép sử dụng, mô hình AI, cấu hình RAG, quyền truy cập và cơ chế giám sát.
Quivr có thể sử dụng mô hình AI cục bộ không?
Có. README chính thức của Quivr cho biết dự án hỗ trợ API của Anthropic, OpenAI và Mistral, đồng thời hỗ trợ mô hình cục bộ thông qua Ollama.
Quivr khác gì so với một AI Agent?
Quivr tập trung vào RAG, truy xuất dữ liệu và cung cấp ngữ cảnh cho ứng dụng AI, trong khi AI Agent thường đảm nhiệm việc điều phối tác vụ, công cụ và quy trình rộng hơn.